

AI駆動開発カンファレンス 2026夏 登壇レポート
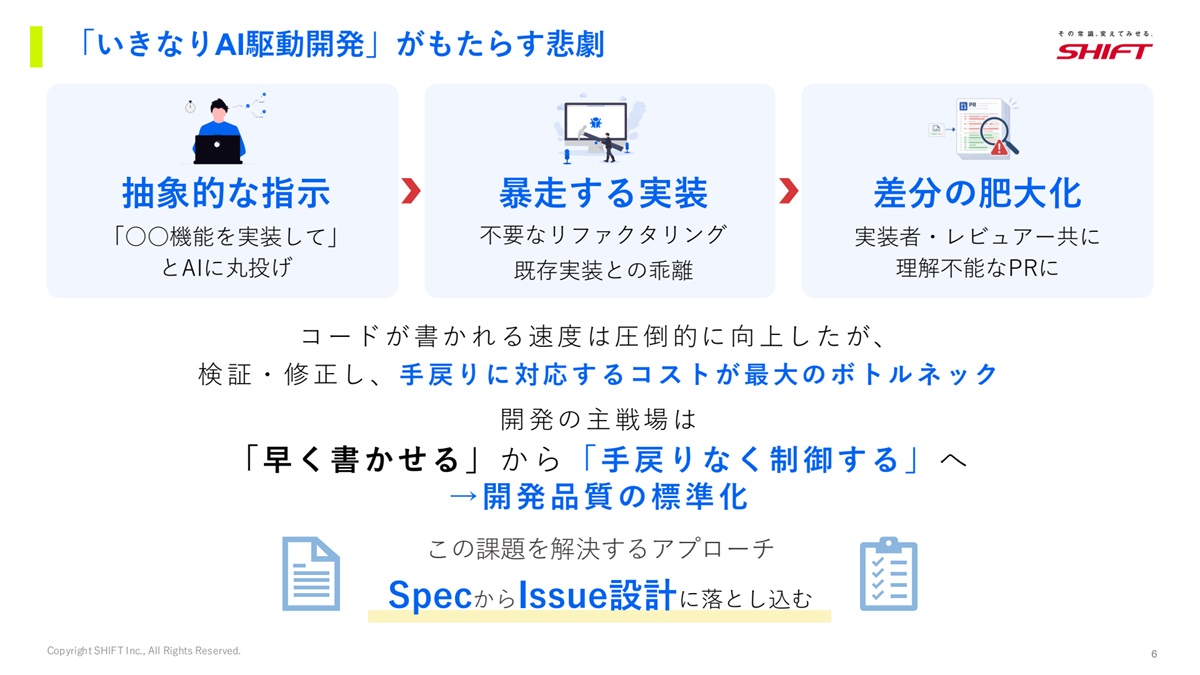
AI駆動開発において、「〇〇機能を実装して」と曖昧な指示を出した結果、対象外のコードまで勝手に書き換えられてプルリクエストの差分が肥大化してしまった……そんな“手戻り”に悩まされた経験はありませんか?
圧倒的なスピードでコードを生成するAIエージェントですが、具体的な完了定義や作業境界が示されていなければ、既存設計を無視した暴走を招きやすく、メンバーごとのアウトプットの品質にもばらつきが生まれてしまいます。
本記事は、2026年7月30日から31日にかけて行われ、SHIFTがスポンサーを務めた「AI駆動開発カンファレンス 2026夏」に登壇した、AI企画推進部 平田 瑞樹の講演内容をレポートします。
AIの行動範囲を物理的に縛るテンプレートや、コンフリクトを回避する“親Issue”の概念といった、現場の失敗から得た“ハーネス(制御装置)の設計方法”を解説。
AIの圧倒的なスピード感を活かしつつ、それらを安全に走らせるための“Issue駆動開発”の極意をお届けします。
-
AI企画推進部 AI内製支援グループ 平田 瑞樹
2024年に新卒としてSHIFTに入社。入社以降、同社の開発メンバーおよび開発リーダーとして複数のプロジェクトで経験を積む。これまでに案件管理システム開発にメンバーとして参画したほか、現在は生成AIを活用したコンタクトセンター向けソリューションの開発チームのリーダーを務めている。

目次
「最初から人間が書いた方がはやかった」という手戻りの罠
AI駆動開発によって、実装未経験のジュニアメンバーであっても、一定レベルのコードを圧倒的なスピードで量産できる環境が整いつつあります。
しかし、これは裏を返せば、「人間側の指示のあいまいさが、そのまま成果物の品質や設計のばらつきに直結する」という新たなリスクの顕在化を意味します。
つまり、これからのAI駆動開発の主戦場は「いかに早く書かせるか」から「いかに手戻りなく制御するか(開発品質をいかに標準化するか)」へと移行しつつあります。
この課題を解決するカギとして、私たちは仕様(Spec)をIssueに落とし込んで開発を制御する、“Issue駆動開発”という新たな開発手法への転換を考えました。
本記事において、Issueとは「AIが迷わず自律実行し、1〜2日程度で完遂できるアトミック(最小単位)な作業チケット」と再定義します。
具体的には、JiraやGitHub Projectなどのタスク管理ツールで用いられるチケットをイメージしてください。
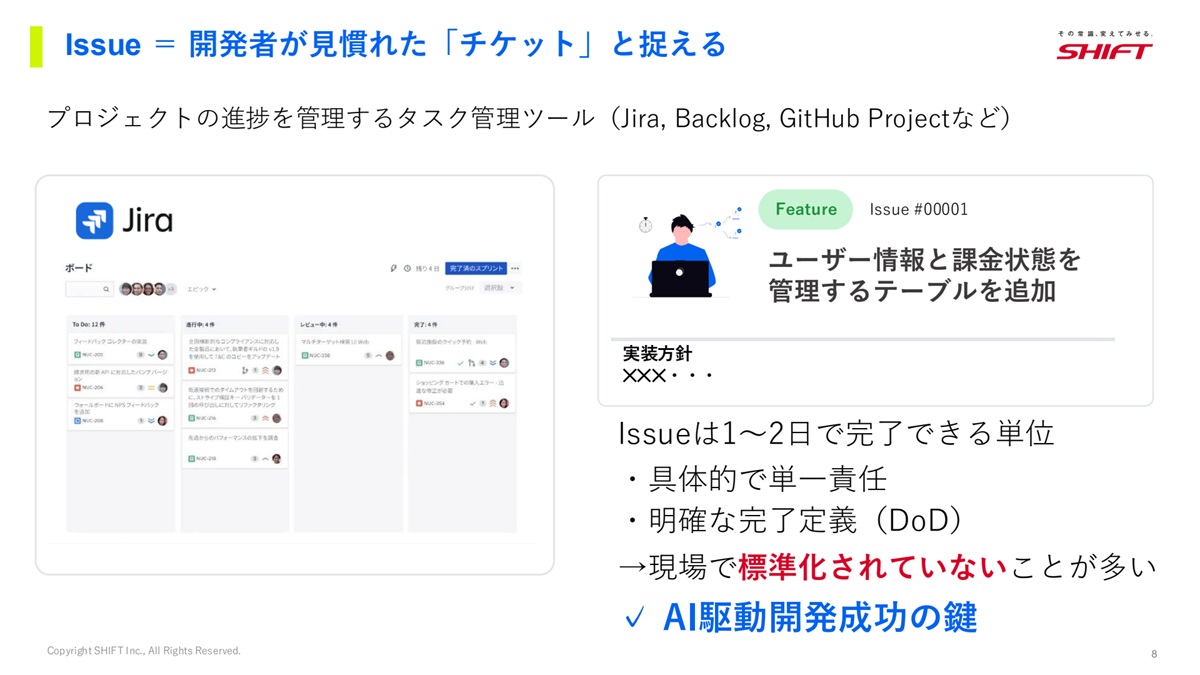
しかし、「そもそもチケットをどのように記述すべきかが標準化されていない」というケースもあるでしょう。
チケットの書き方が開発者ごとに属人化していると、AIへのインプットが統一されず、アウトプットの品質もばらつきが生じます。
Issue駆動開発は、チケットに「何を、どう書くか」という記述のフォーマットを仕組みとして定義し、AIへのインプット品質を揃える“Issue設計”のプロセスを踏みます。
詳しくは後述しますが、AIにタスクを渡す前に、設計の妥当性を人間同士で議論し合意形成する“Issue設計レビュー”を徹底することで、指示の属人性を排除し、AIが迷わず完遂できるレールをあらかじめ敷いておくのです。
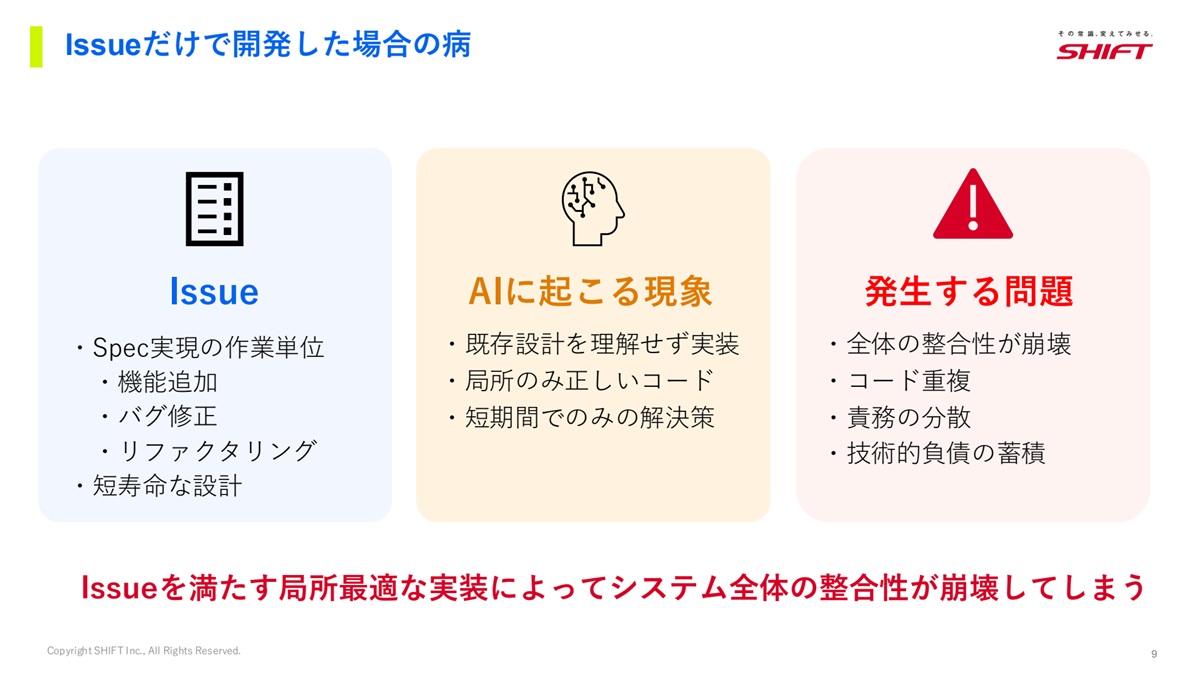
ただしIssue駆動開発は、Issueだけで開発を進めるわけではありません。そうすると、AIはそのタスクの範囲内だけで閉じた、局所最適な解決を図ろうとするからです。
その結果、リポジトリ全体で見たときのシステム整合性が崩壊し、コードの重複や責務の混乱といった技術的負債が一気に蓄積してしまいます。
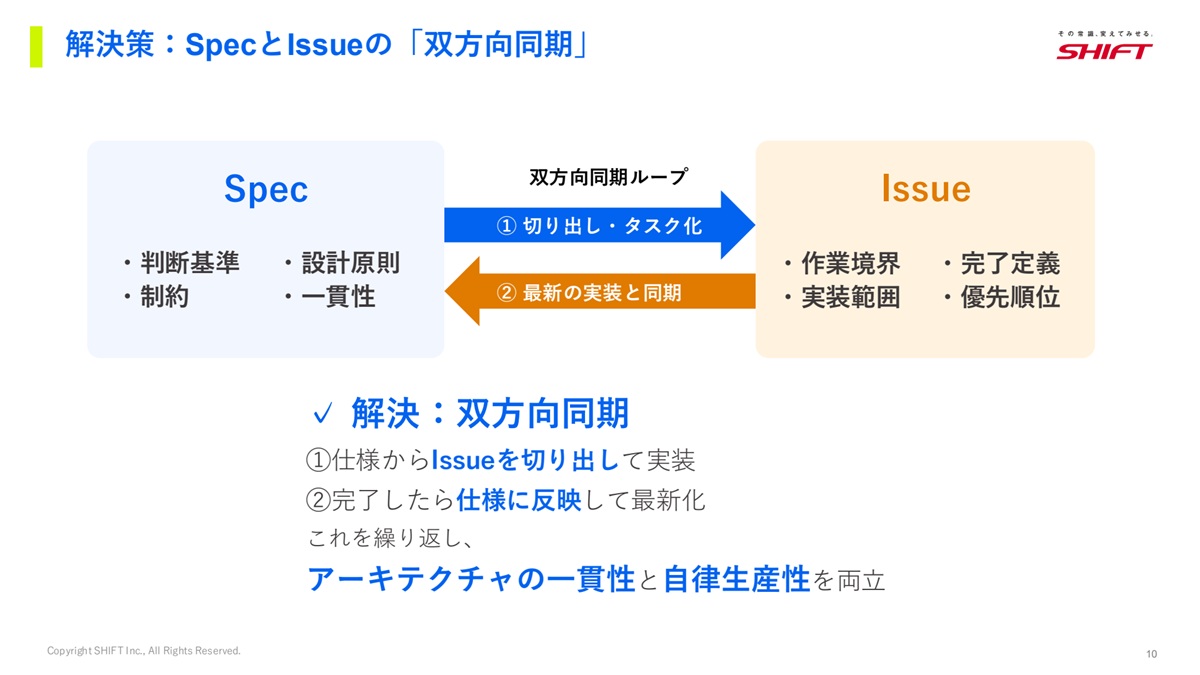
これを防ぐためには、判断基準や一貫性を担保するSpecの責務と、作業境界や完了定義を示すIssueの責務を切り分け、双方が同期するループ構造を構築することが重要です。
AI駆動開発では暗黙知は通用しない。2つの失敗事例と解決策
私たちはIssue駆動開発を確立するまでに、2つの壁に直面しました。
壁1:変更範囲の肥大化
最初の壁は、変更範囲の肥大化です。人間同士であれば「今回はここだけ移行すればいい」という暗黙知が働きます。しかし、AIエージェントにはその前提が通用しません。
AIは気を利かせて推論を勝手に拡大し、スコープ外の関連クラスまで一気に書き換えてしまいます。
その結果、数十ファイルに及ぶ巨大な変更が含まれたプルリクエストが生成され、レビュー不能な状態に陥ってしまいました。
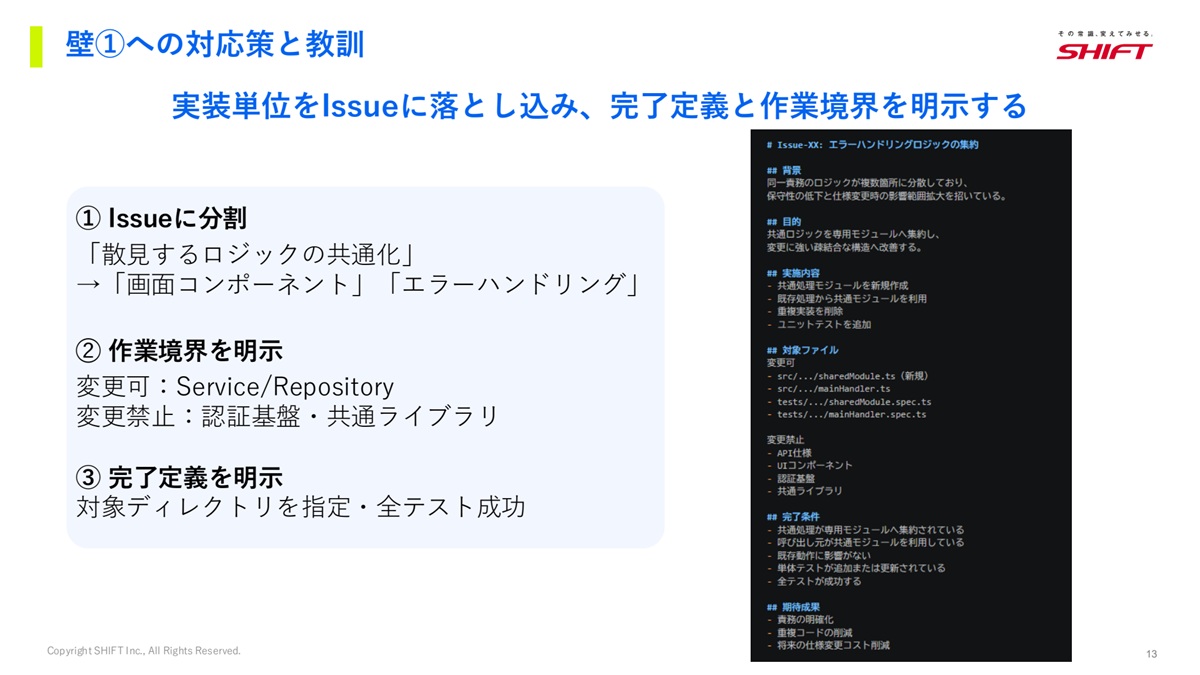
そこで、散在するロジックの共通化といった大きなタスクを、実装単位まで細分化しました。
その上で、チケット内に「変更を許可するファイル」と「変更を絶対に禁止するファイル」を明記し、達成すべき期待結果(完了定義)をテンプレートに沿って記述。
AIが余計な推論を行わず、定められた範囲で動作できるようにしました。
壁2:作業の重複とコンフリクト
2つ目の壁は、複数のAIを並行して稼働させたときに起きた“作業の重複とコンフリクト”。
例えば、新しい画面の実装において、フロントエンドのタスクチケットとバックエンドのタスクチケットを、それぞれ別々のAIエージェントに同時に割り当てて開発を依頼しました。
すると、フロントエンド担当のAIが「まだAPIがない」と判断し、勝手にAPIまで実装してしまいました。
プルリクエストの段階で作業の重複が発覚し、コンフリクト解消に無駄な時間を費やすことになります。
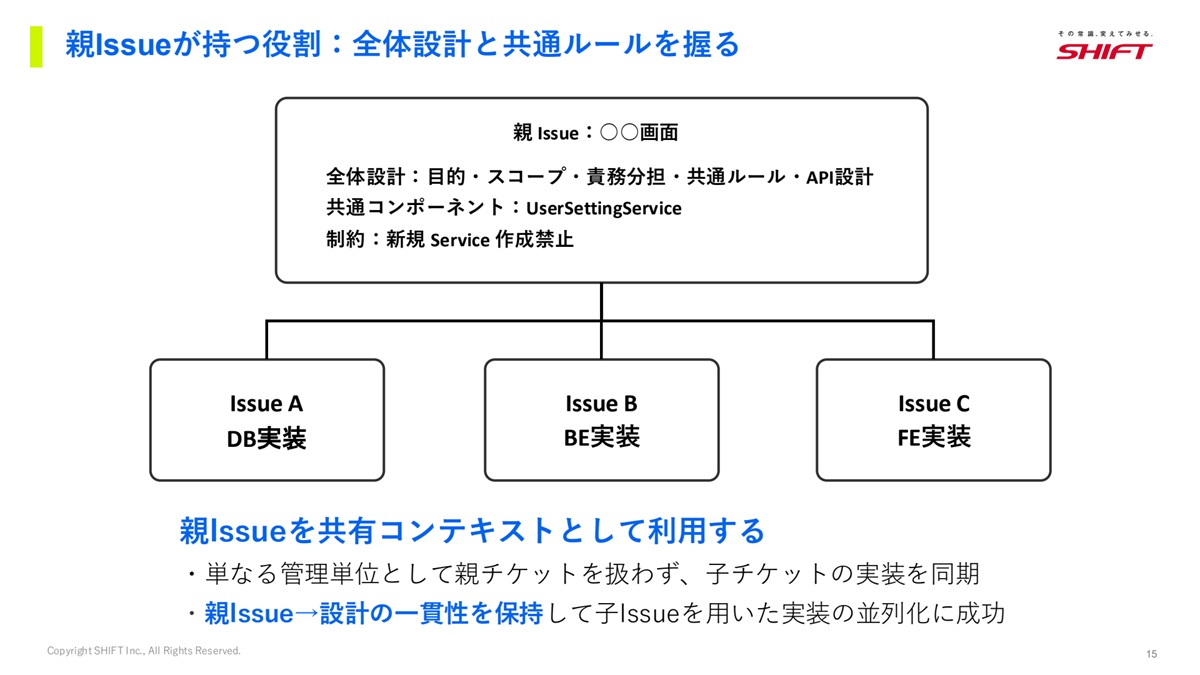
この解決策として、関連するタスクを束ねる“親Issue”という概念を導入しました。親Issueに全体設計、スコープ、使用するテーブルなどの共通ルールを握らせます。
そして、個別のタスクである“子Issue”を実装するAIには、必ず事前に親Issueを確認するよう指示します。
これにより、並行して走るAIエージェント同士が全体の文脈や順序依存を理解し、作業重複を早期に検出・回避できるようになりました。
これらの失敗から得られた教訓は、AI駆動開発においては「人間同士の暗黙知に依存してはならない」ということです。
システムの境界を定義・言語化し、AIが脱線することのないようにレールを敷くこと。これが、手戻りの削減につながる重要な考え方です。
実践!仕様と実装を乖離させない、Issue駆動開発のプロセス
ここからは、私たちのチームが実践している、具体的な開発プロセスの全貌をご紹介します。このプロセスは、人間が行う「上流のIssue設計」と、AIエージェントが自律的に実行する「下流の自動実装・同期」の2つのフェーズに分かれています。
【Issue設計】
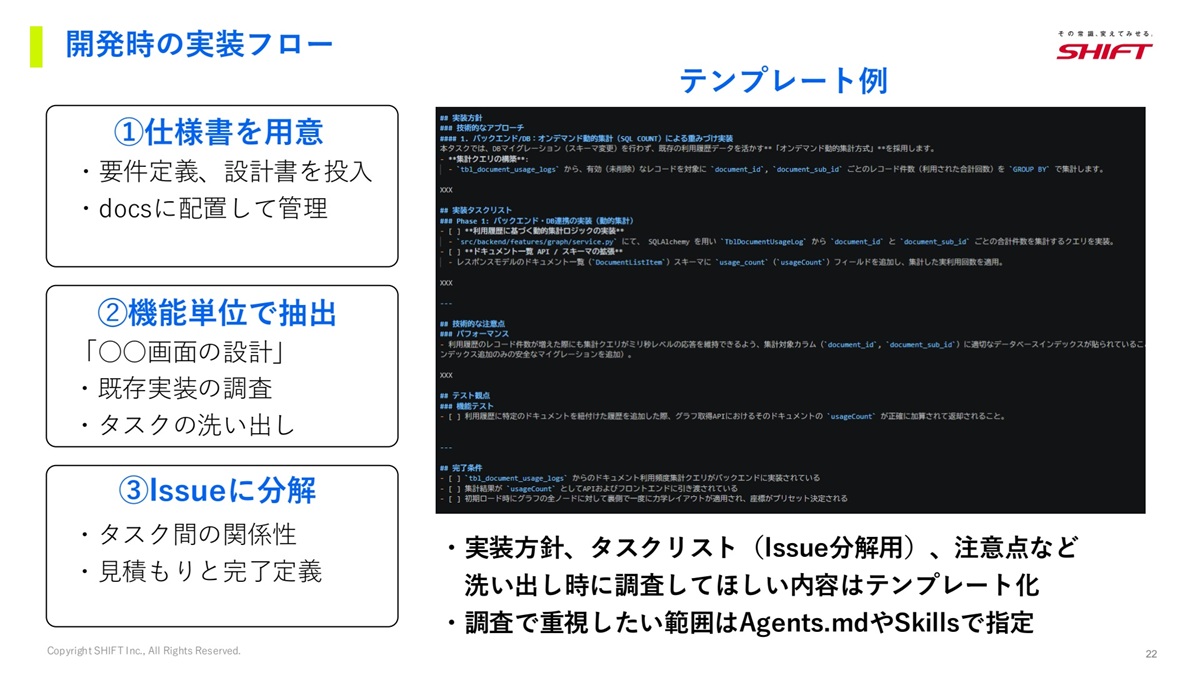
1.仕様書を用意:要件定義書や基本設計書などのドキュメントを、リポジトリ内に格納し、一元管理します。
2.機能単位で抽出:仕様書をもとに、画面単位や機能単位(親チケットの粒度)で整理を行い、既存実装の調査や問題となりそうなポイントの洗い出しを行います。
3.Issueに分解:機能Issue単位に分解し、依存関係、見積もり、完了定義を明確にします。
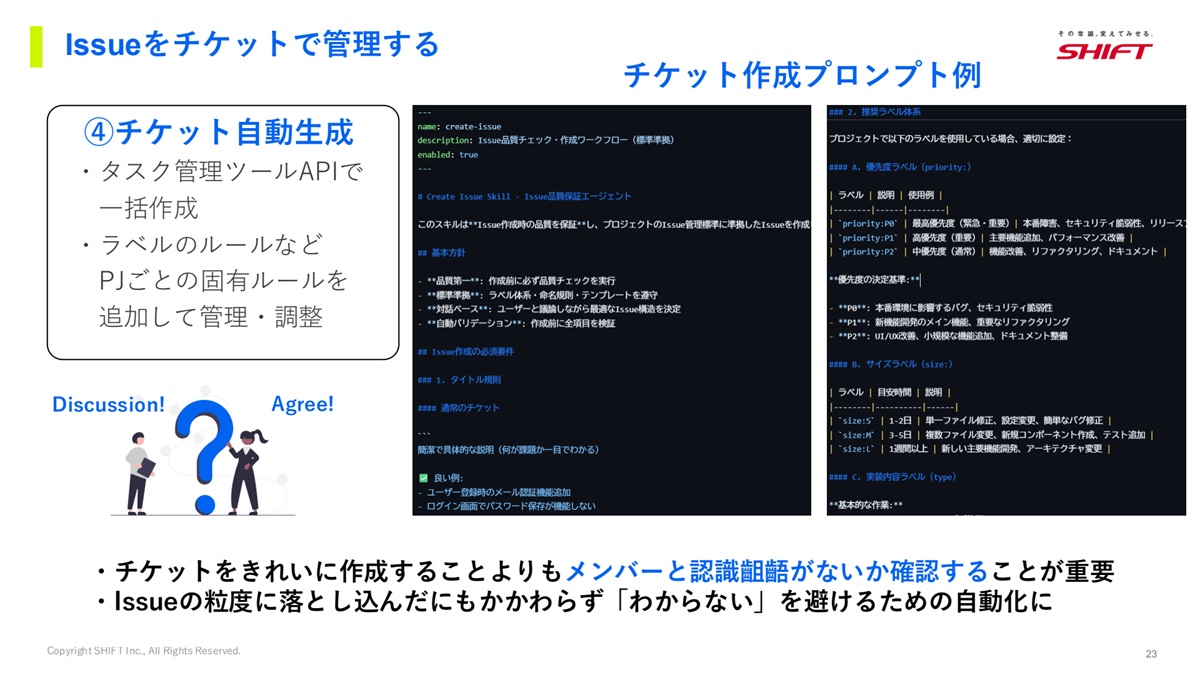
★Issue設計レビュー:AIにタスクを渡す前に、「完了定義に漏れはないか」「作業境界は正しいか」「このチケット記述で、開発メンバー全員が同じ認識をもてるか」をチームメンバー間でレビューし、合意を形成します。
4.チケット自動生成:タスク管理ツールのAPIを介して、一括でチケットを生成します。
【実装・同期プロセス:後半】
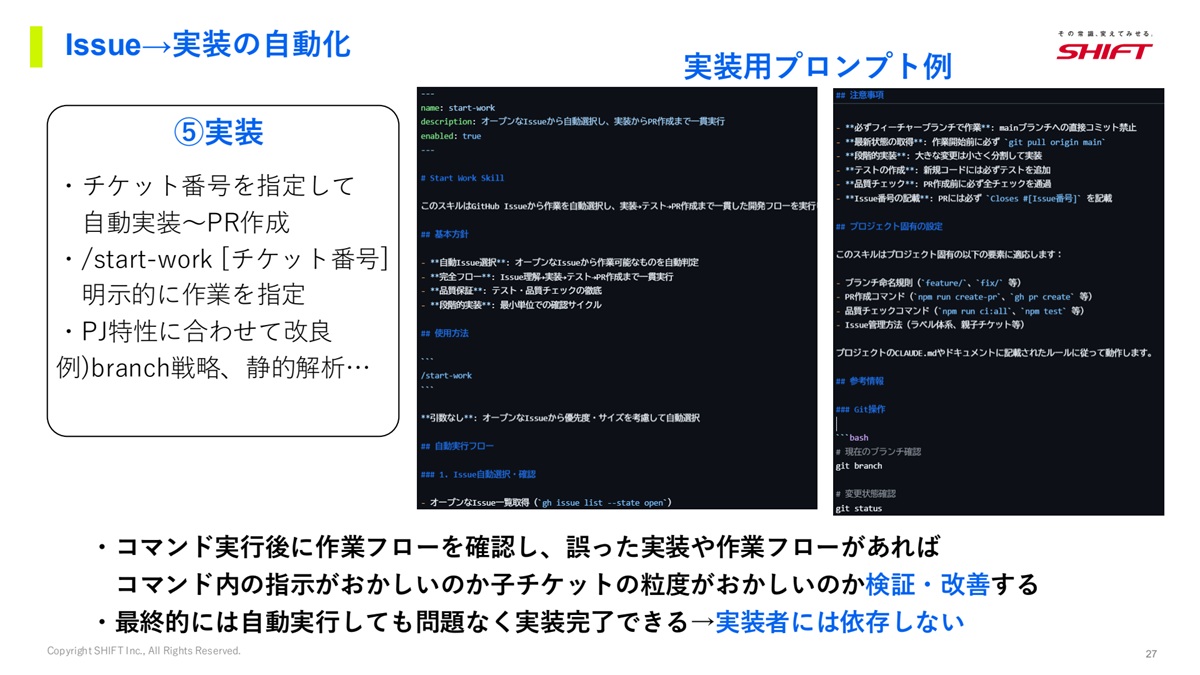
5.実装(自動化):システムがチケットの完了定義を読み込み、AIエージェントがコードの自動生成からプルリクエストの作成までを自動で完遂します。
もし誤った実装が発生した場合は、実装用プロンプトの修正だけでなく、「Issueの粒度が適切だったか」と設計フェーズまで遡って改善を回します。
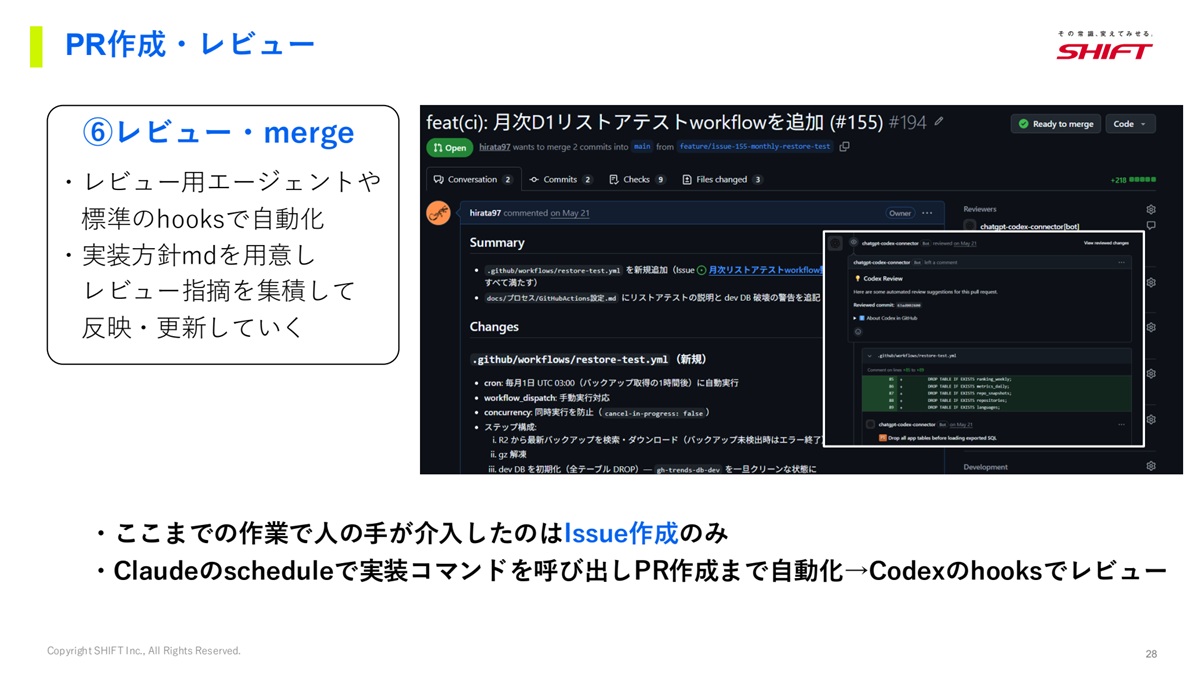
6.レビュー・merge:レビュー専用のエージェントを用意し、標準のGit hooksなどを活用してレビュー作業を自動化。レビュー指摘を集約したMarkdown形式のドキュメントを用意し、日々の知見を蓄積していきます。
最後に行うのが、実装完了後の仕様同期です。開発の現場では、実装が進むにつれて設計書が陳腐化していく実態との乖離が大きな課題でした。
そこで私たちは、AIが実装完了した際のソースコードの差分を検出し、リポジトリ内の仕様書ドキュメントに対して自動で書き戻し(追記・更新)を行うコマンドを構築。
この双方向同期ループを回しつづけることで、ドキュメントがつねに“システムの現在地”を示しつづけるようになり、次のIssue設計も常に最新かつ正しい仕様前提で進められます。
仕組みがエンジニアの力量差をカバー。開発チーム全体の“品質の下限”を引き上げる
Issue駆動開発を導入した最大の成果は、AIモデルの性能や開発メンバーのスキルへの依存を抑えられることです。
私たちは、高度な推論やアーキテクチャの決定といったプロセスをIssue設計という人間の上流フェーズを主に切り出しています。
そのため、異なるAIモデル(Anthropic、OpenAI、Googleなど)を利用しても、出力品質のブレが少なくなります。
実際、私たちのチームで実施した検証においても、最上位モデル(例:Claude 3 Opus)と中位モデル(例:Claude 3.5 Sonnet)を比較した際、最終的な実装品質に予想以上の差は見られませんでした。
優秀な特定のエンジニアの個人スキルや、過剰に高性能なAIモデルの力に依存する開発から脱却し、仕組みによって開発チーム全体の“品質の下限(ボトムライン)”を引き上げる。
これが、Issue設計の真の価値です。
AI時代のエンジニアの役割は、ハーネスエンジニアリングのデザイナーへ
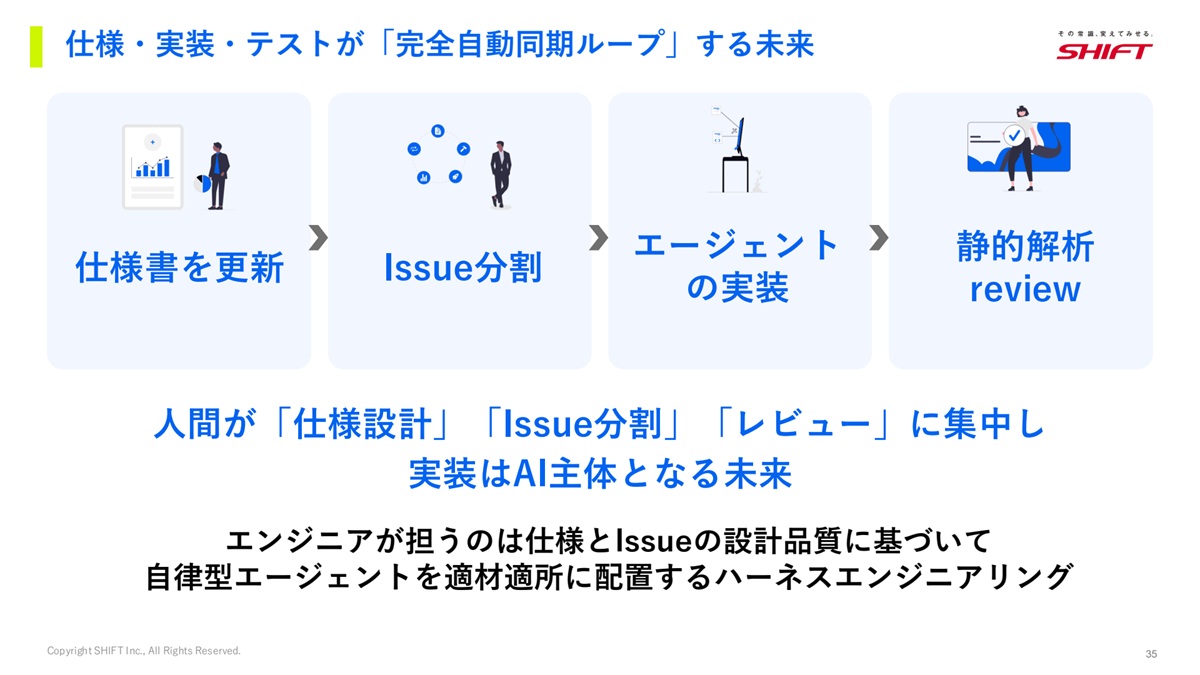
仕様、実装、テスト、そしてドキュメントへの同期までもが完全に自動同期ループする未来の開発環境において、エンジニアが担うべき専門領域は、自らコードを書くことではなく、ハーネスエンジニアリングへとシフトしていく可能性があります。
ハーネスとは、自律的に動くAIエージェントが暴走しないように敷く「制御用のレールと境界線の仕組み」です。
今後のエンジニアに求められるスキルは、コードを書く力ではなく、このハーネスをデザインし、適材適所にエージェントを配置して監督する能力が重要になると考えられます。
そして、ハーネスエンジニアリングという新たな役割を担ううえで、エンジニアが実際に行うもっとも重要な役割が、先述のIssue設計レビューなのです。
これまでは出来上がったコードをレビューしていましたが、それでは手戻りコストが大きすぎます。
これからは、AIにタスクを渡す前のチケット作成段階において、「完了定義は妥当か」「作業境界は正しく閉じているか」「実装方針に問題はないか」を人間同士で事前に議論し、合意形成を行う必要があります。
現在、私たちは個人が受けたレビュー指摘などをMarkdownで蓄積し、自分特化のレビュー指摘エージェントをつくるなど、個人の特性に応じた最適化を実験しています。
今後は、個人の知見をチーム全体へ共有し、組織の資産として統合することを課題としています。
標準化によって“品質の下限”を引き上げると同時に、個人のナレッジによって“品質の上限”を引き上げる。この両輪を回すことが今後の最適化に繋がると考えています。
(※本記事の内容および取材対象者の所属は、イベント開催当時のものです)